La brecha de la IA no es una brecha de acceso. Es una brecha de implementación. Casi todas las empresas tienen la misma IA, y desde el 7 de octubre de 2026 el modelo pequeño de Anthropic cuesta 0,10 dólares por millón de tokens de entrada. Lo que muy pocas tienen son sus procesos escritos de forma que una IA pueda ejecutarlos. Los tienen en la cabeza de tres personas.
¿Qué ha cambiado con Claude Haiku 5.5?
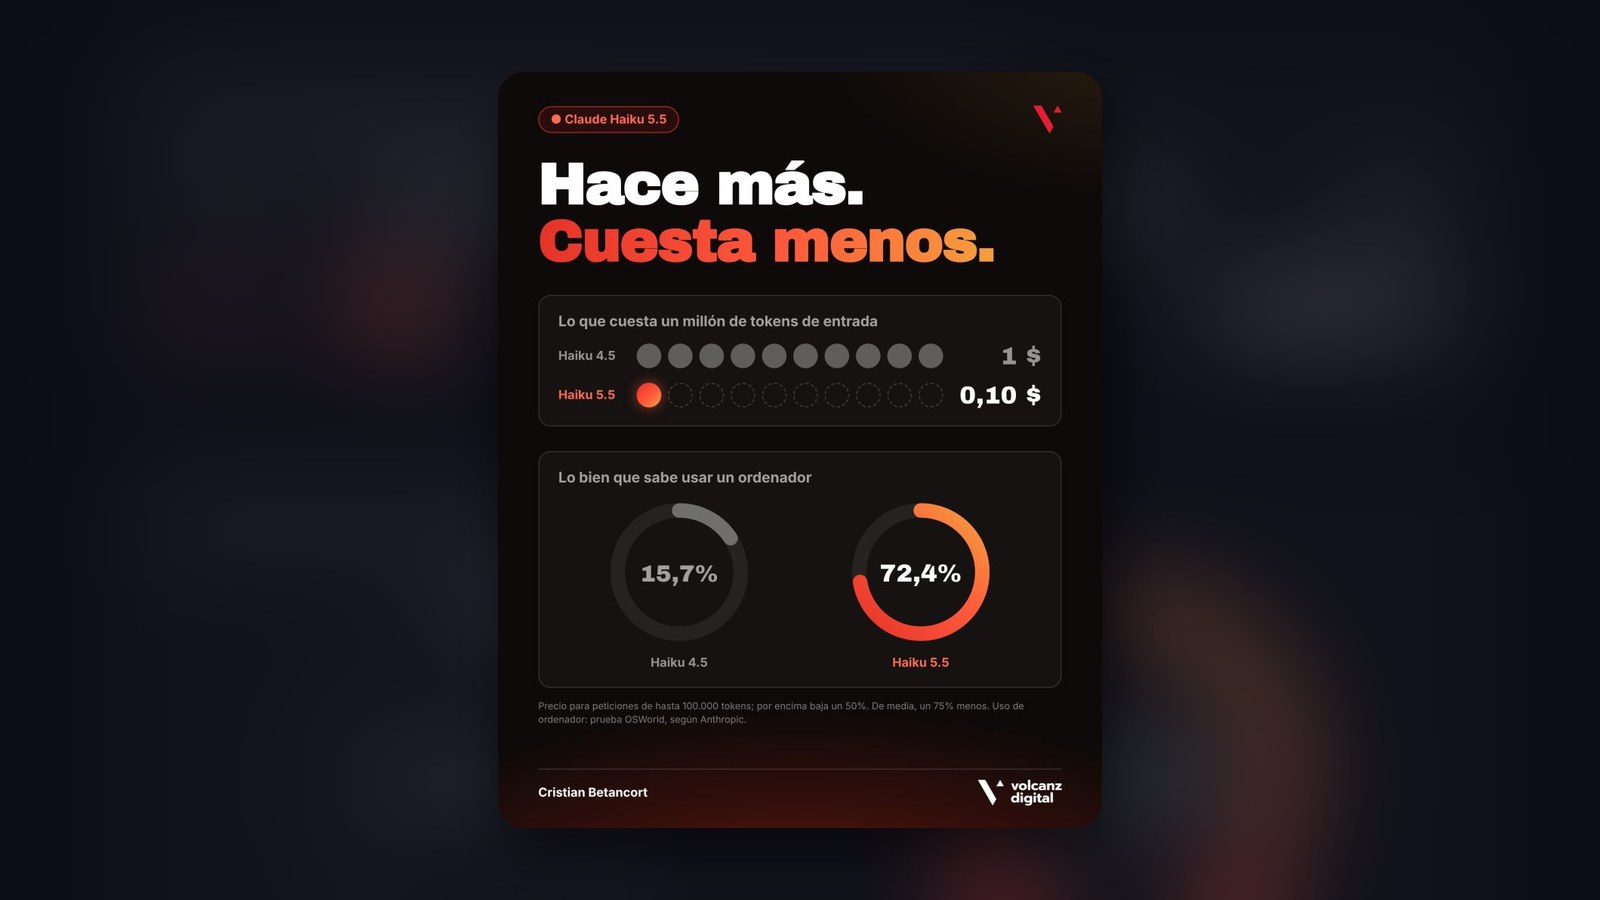
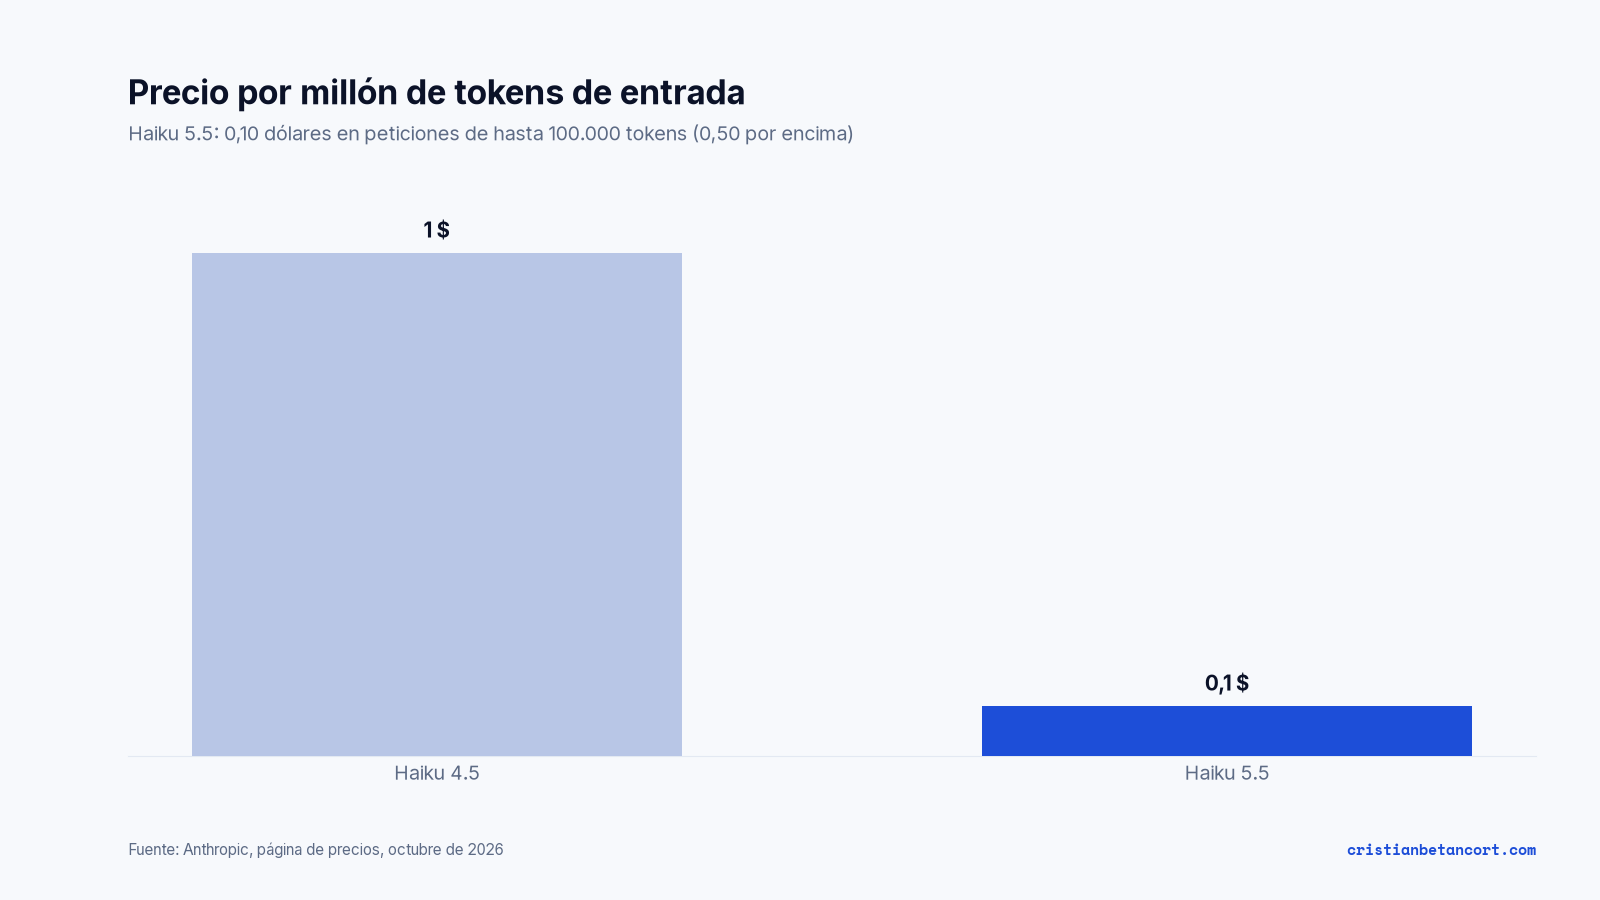
El 7 de octubre Anthropic lanzó Claude Haiku 5.5, su modelo pequeño. He contrastado las cifras con la página oficial de precios y coinciden con lo que publiqué en LinkedIn:
| Modelo | Entrada ($/millón de tokens) | Salida ($/millón de tokens) | Lectura de caché ($/millón) |
|---|---|---|---|
| Haiku 4.5 | 1,00 | 5,00 | 0,10 |
| Haiku 5.5 (peticiones de hasta 100.000 tokens) | 0,10 | 0,50 | 0,01 |
| Haiku 5.5 (peticiones de más de 100.000 tokens) | 0,50 | 2,50 | 0,05 |
| Sonnet 5.5 | 2,00 | 10,00 | 0,10 |
| Opus 5.5 | 4,00 | 20,00 | 0,20 |
Tres matices que conviene tener claros:
- El "75% más barato" es una media. Anthropic lo explica en una nota al pie: la bajada es del 90% para peticiones de hasta 100.000 tokens y del 50% por encima. Como la inmensa mayoría de las peticiones a Haiku 4.5 estaban por debajo de ese umbral, la media ponderada sale en torno al 75%. Además, el nuevo tokenizador consume algo más de tokens por tarea, y la cuenta ya lo tiene en cuenta.
- El salto en capacidad es mayor que el de precio. En OSWorld 2.1, la prueba que mide si un modelo sabe usar un ordenador, Haiku 5.5 pasa del 15,7% de Haiku 4.5 al 72,4%. Son cifras del propio fabricante, así que conviene tomarlas con cautela, pero el orden de magnitud es claro.
- Para programación compleja, Sonnet y Opus siguen por delante. Lo dice Anthropic en su propia página: en Terminal-Bench 4.0, Haiku 5.5 saca un 39,2% frente al 70,6% de Sonnet 5.5. Haiku está pensado para resúmenes, clasificación, consultas a bases de datos y para trabajar como subagente de un modelo grande.
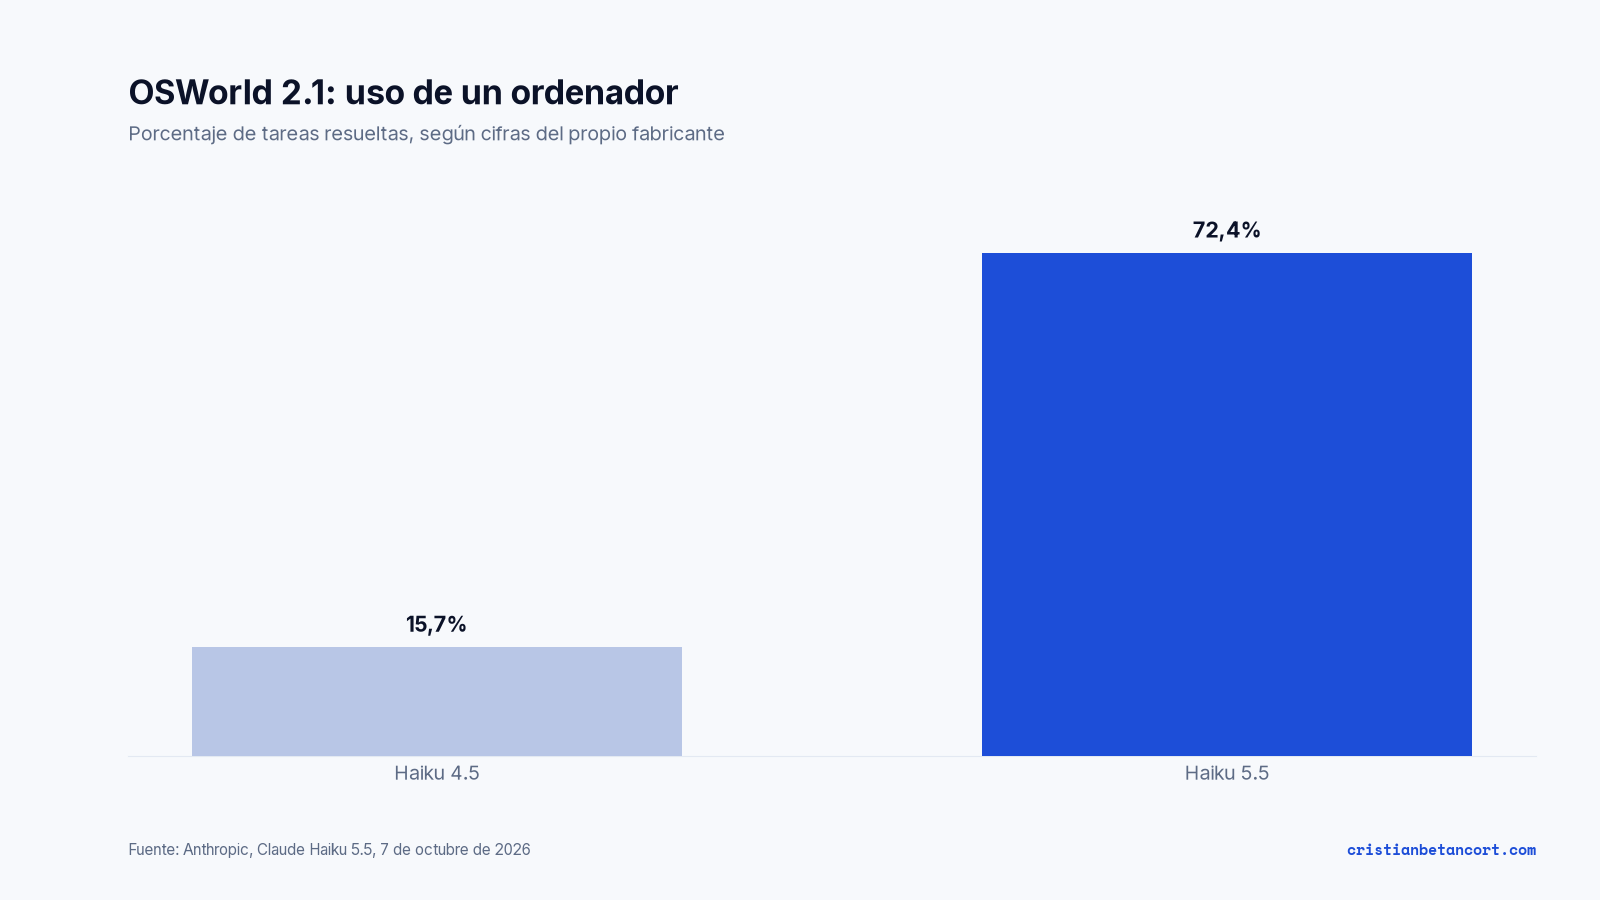
Ojo: los resultados de OSWorld y Terminal-Bench los publica Anthropic sobre su propio modelo. El orden de magnitud es creíble; la cifra exacta, tómala con cautela hasta que haya evaluaciones externas.
¿Cómo calcular si una automatización compensa?
Hagamos la cuenta que puse en LinkedIn, ahora con los precios verificados. Imagina una tarea pequeña y repetitiva: leer un correo, una ficha o una transcripción (unos 20.000 tokens de entrada) y producir una clasificación o un resumen (unos 1.000 tokens de salida). La repites 10.000 veces al mes.
| Concepto | Haiku 4.5 | Haiku 5.5 |
|---|---|---|
| Entrada: 20.000 tokens × 10.000 = 200 millones de tokens | 200 × 1,00 $ = 200 $ | 200 × 0,10 $ = 20 $ |
| Salida: 1.000 tokens × 10.000 = 10 millones de tokens | 10 × 5,00 $ = 50 $ | 10 × 0,50 $ = 5 $ |
| Total mensual | 250 $ | 25 $ |
250 $ → 25 $ al mes para la misma tarea de 20.000 tokens de entrada y 1.000 de salida repetida 10.000 veces. — Cálculo propio con la página de precios de Anthropic
Si además procesas por lotes (la API de Batch tiene un 50% de descuento) y parte del contexto se repite y entra en caché, baja todavía más. Hablamos de céntimos por tarea.
Pero el coste de los tokens es solo una línea de la cuenta. La fórmula completa que yo uso para decidir si una automatización compensa tiene cuatro términos:
- Coste actual de la tarea. Horas que dedica una persona al mes multiplicadas por su coste por hora. Si nadie sabe este número, ese es el primer problema.
- Coste de tokens. El cálculo de arriba. Con Haiku 5.5, casi siempre es la cifra más pequeña de las cuatro.
- Coste de diseño. Las horas de escribir el proceso, probarlo con casos reales y corregirlo. Es un coste único, pero no es pequeño. Suele ser lo que de verdad decide si el proyecto sale adelante.
- Coste de revisión. Las horas que una persona dedicará cada mes a revisar lo que hace la IA, más el coste de los errores que se cuelen. Es un coste recurrente y es el que casi todo el mundo olvida.
La automatización compensa cuando el coste actual supera con claridad la suma de tokens más revisión, y el ahorro mensual amortiza el diseño en un plazo razonable. En mi experiencia, cuando la cuenta no sale no es por el precio por token. Es porque el coste de diseño se dispara al descubrir que nadie sabe exactamente cómo se hace la tarea.
¿Por qué el precio ya no es la barrera?
Hace dos años, automatizar la lectura de 10.000 documentos al mes con un modelo decente costaba lo suficiente como para que hubiera que justificarlo. Hoy cuesta lo que un almuerzo. El coste se ha movido de sitio: el precio por token ya no es el problema. Lo caro ahora es diseñar bien el proceso y revisar lo que hace la IA.
Esto tiene una consecuencia incómoda. Casi todas las empresas tienen acceso a los mismos modelos, a los mismos precios, el mismo día. La ventaja competitiva no está ahí. Está en cuántos de tus procesos existen por escrito con el nivel de detalle que una IA necesita para ejecutarlos. Y ahí la foto suele ser esta: el proceso está en la cabeza de tres personas, cada una lo hace un poco distinto, y lo que hay documentado es un PDF de 2019 que nadie abre.
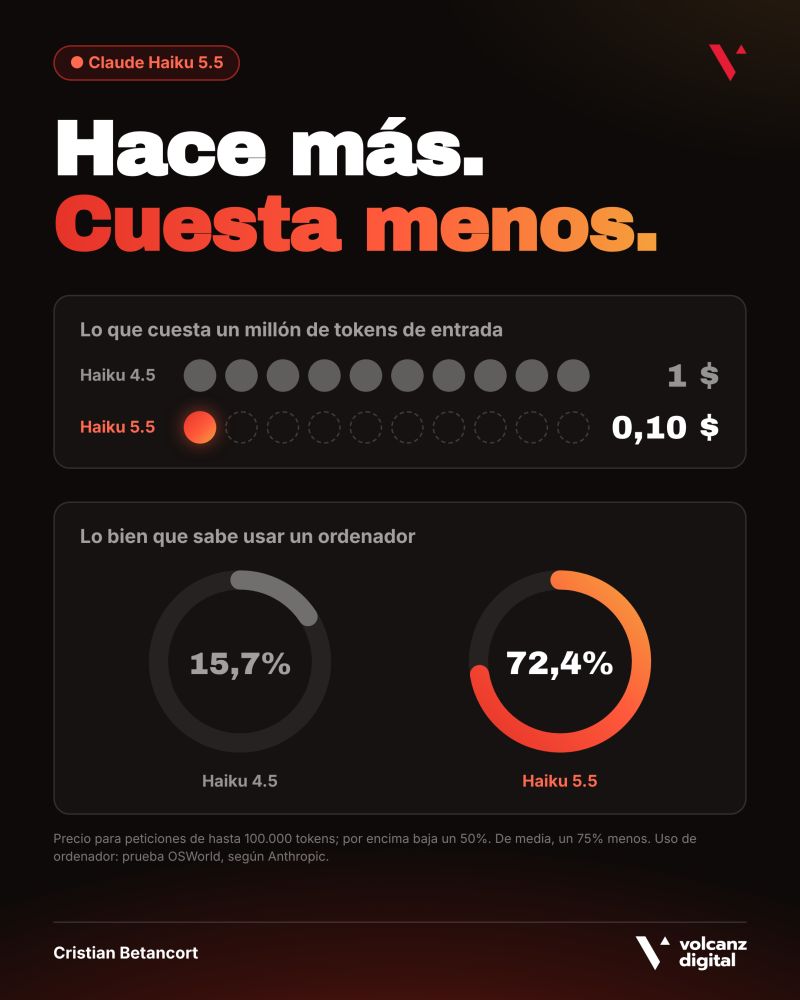
Una IA barata no arregla un proceso mal pensado. Solo hace que vaya más rápido.
Cómo escribir un proceso para que una IA lo pueda ejecutar
Este es el marco que aplico cuando me siento con un equipo a convertir una tarea en algo que un modelo pueda ejecutar. Son cinco bloques. Si falta uno, la automatización fallará, y no por culpa del modelo.
| Bloque | Pregunta que responde | Ejemplo: clasificar correos de soporte |
|---|---|---|
| 1. Inputs | ¿Qué recibe exactamente la IA y en qué formato? | Asunto, cuerpo, remitente, historial del cliente si existe. Nada más. |
| 2. Reglas | ¿Cómo se decide en los casos normales? | Categorías cerradas (facturación, incidencia técnica, baja, comercial, otros) con una definición de una frase cada una. |
| 3. Excepciones | ¿Qué casos no sigue las reglas y qué se hace con ellos? | Amenaza legal, cliente VIP, idioma no soportado: se marcan como "escalar" y no se clasifican. |
| 4. Criterio de calidad | ¿Cómo sabemos que el resultado está bien? | Coincidencia con la etiqueta que pondría un agente senior en al menos el 95% de una muestra de 200 correos. |
| 5. Punto de revisión humana | ¿Quién mira qué, cuándo y qué puede parar? | Un agente revisa el 5% de las clasificaciones cada semana y el 100% de las marcadas como "escalar". |
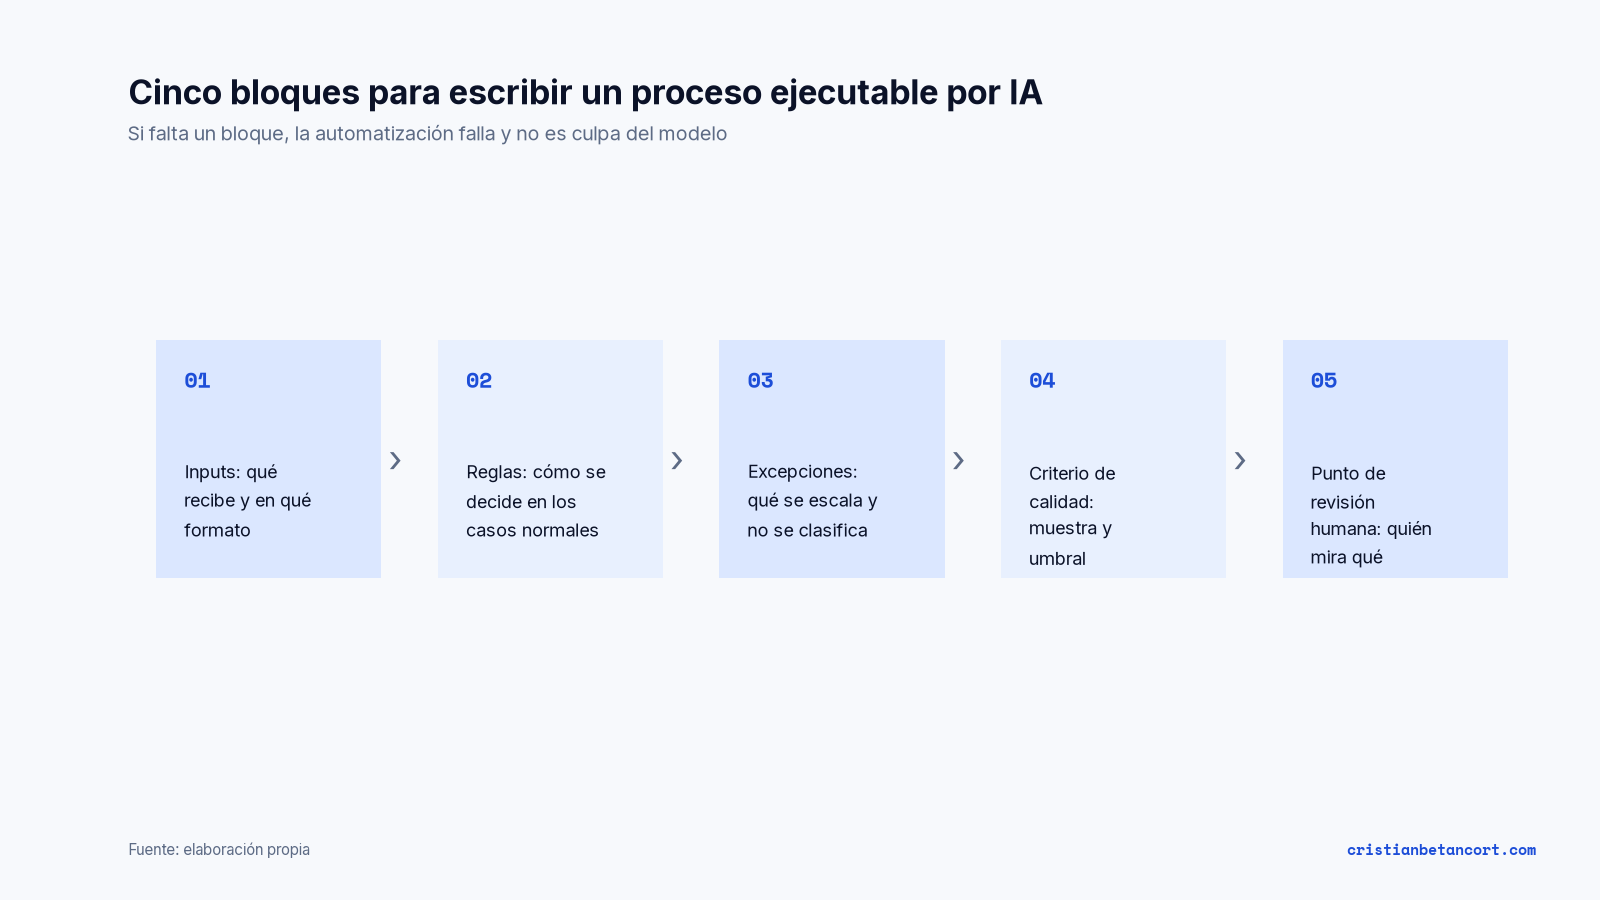
Algunas notas sobre cada bloque:
- Inputs. Menos es más. Cada dato que le pasas al modelo cuesta tokens y añade ruido. Si una persona no lo necesita para decidir, la IA tampoco.
- Reglas. Aquí es donde aparece la brecha de implementación. Cuando pides a tres personas que escriban las reglas de una tarea que llevan años haciendo, salen tres versiones. Reconciliarlas es el trabajo de verdad. Y es un trabajo que mejora la empresa aunque luego no automatices nada.
- Excepciones. Un proceso sin excepciones escritas es un proceso que la IA ejecutará con confianza en los casos en que no debería. Lo que para una persona es obvio ("esto huele raro, se lo paso al jefe") para un modelo tiene que estar escrito.
- Criterio de calidad. Si no puedes medir si el resultado es bueno, no puedes saber si la automatización funciona. Define una muestra, un umbral y quién lo comprueba antes de poner nada en marcha.
- Punto de revisión humana. Es el bloque que une este artículo con el anterior sobre cuellos de botella. Si la revisión no está diseñada, acabará siendo el cuello de botella de todo el proceso.
¿Por qué repartir el trabajo entre un modelo grande y varios pequeños?
Con esta diferencia de precio, la arquitectura más sensata para muchos procesos es que un modelo grande planifique y varios pequeños ejecuten. Anthropic lo sugiere en la propia página de Haiku 5.5: lo presenta como subagente de Opus 5.5 y Sonnet 5.5. En la práctica significa esto:
- El modelo grande recibe la tarea completa, la descompone y decide qué hay que hacer con cada parte.
- Los modelos pequeños hacen las partes repetitivas: leer, clasificar, extraer, resumir. A 0,10 dólares por millón de tokens, puedes permitirte que lo hagan muchas veces.
- El modelo grande (o una persona) revisa el conjunto.
72,4 % en OSWorld 2.1 frente a 39,2 % en Terminal-Bench 4.0: Haiku 5.5 sabe usar un ordenador, pero para programación compleja Sonnet 5.5 (70,6 %) sigue por delante. — Anthropic, 7 de octubre de 2026
Ojo con el umbral de los 100.000 tokens. Si el proceso mete contextos enormes en cada petición, Haiku 5.5 pasa a costar cinco veces más. Trocear bien la tarea no es solo una cuestión de calidad; también es una cuestión de factura.
¿Por dónde empezar?
No empieces por el modelo. Empieza por elegir una tarea pequeña, repetitiva y con un resultado fácil de comprobar. Pide a las personas que la hacen que la escriban con los cinco bloques del marco. Compara las versiones. Lo que descubras en esa comparación vale más que cualquier demo.
¿Cuántos procesos de vuestra empresa existen hoy por escrito con ese nivel de detalle? ¿Y cuántos están solo en la cabeza de alguien?
Preguntas frecuentes
¿Cuánto cuesta Claude Haiku 5.5?
Según la página de precios de Anthropic, 0,10 dólares por millón de tokens de entrada y 0,50 por millón de salida en peticiones de hasta 100.000 tokens. Por encima de ese umbral, 0,50 y 2,50 dólares. Haiku 4.5 costaba 1 y 5 dólares respectivamente.
¿Qué es la brecha de implementación de la IA?
La diferencia entre tener acceso a la IA y tener procesos escritos de forma que una IA pueda ejecutarlos. Casi todas las empresas tienen lo primero. Muy pocas tienen lo segundo: los procesos están en la cabeza de las personas, no documentados con inputs, reglas, excepciones y criterios de calidad.
¿Cómo sé si una automatización con IA compensa?
Compara el coste actual de la tarea (horas por coste hora) con la suma del coste de tokens y del coste recurrente de revisión, y comprueba cuánto tarda el ahorro en amortizar el coste único de diseño. Con los precios actuales, los tokens casi nunca son el problema; el diseño y la revisión sí.
¿Sirve Haiku 5.5 para cualquier tarea?
No. Anthropic lo recomienda para resúmenes, clasificación, consultas a bases de datos y como subagente. Para programación compleja y tareas agénticas largas, Sonnet 5.5 y Opus 5.5 siguen por delante según sus propias pruebas.
Fuentes
- Claude Haiku 5.5, página oficial de Anthropic con precios, nota sobre el 75% y resultados en OSWorld 2.1 y Terminal-Bench 4.0 (7 de octubre de 2026).
- Pricing, documentación oficial de la plataforma de Claude (precios por tramo de 100.000 tokens, caché y Batch).
- Publicación original en LinkedIn de Cristian Betancort (8 de octubre de 2026).
COO & Head of Digital (AI) en Volcanz Digital y director del Máster, cursos y talleres de IA aplicada al Marketing Digital en DKS. Escribo cada semana sobre IA, búsqueda y operaciones. Sígueme en LinkedIn.