ChatGPT responde 6 de cada 7 preguntas sin buscar en internet. Solo el 14,4% de las respuestas de la versión gratuita lanza una búsqueda web; el resto sale de lo que el modelo ya tiene aprendido. Y cuando busca, cada vez tira más de la fuente oficial y menos de quien resume a otros. Es la conclusión del estudio que Ahrefs publicó el 12 de octubre de 2026 tras analizar 66,6 millones de respuestas.
¿Qué ha medido exactamente Ahrefs?
Conviene empezar por aquí, porque el titular es llamativo y el detalle importa. Ahrefs, con Louise Linehan como autora, analizó 66,6 millones de respuestas de ChatGPT en su versión gratuita y sin iniciar sesión (modelo GPT-5.6 Luna), generadas en agosto y septiembre de 2026 en todos los países. De esas respuestas salieron 15 millones de búsquedas internas, lo que en inglés llaman query fan-out: las consultas que el modelo lanza por detrás cuando decide que necesita información fresca.
Hay un segundo conjunto de datos, separado del anterior: las citas. Aquí Ahrefs usa su herramienta Brand Radar y mira qué dominios aparecen citados en respuestas de ChatGPT en Estados Unidos entre marzo y septiembre de 2026, con entre 2,4 y 3,8 millones de respuestas por mes.
Son dos muestras distintas. La primera dice cuándo y cómo busca ChatGPT. La segunda, a quién cita cuando responde. No conviene mezclarlas como si fueran la misma cosa.
¿Con qué frecuencia busca ChatGPT en la web?
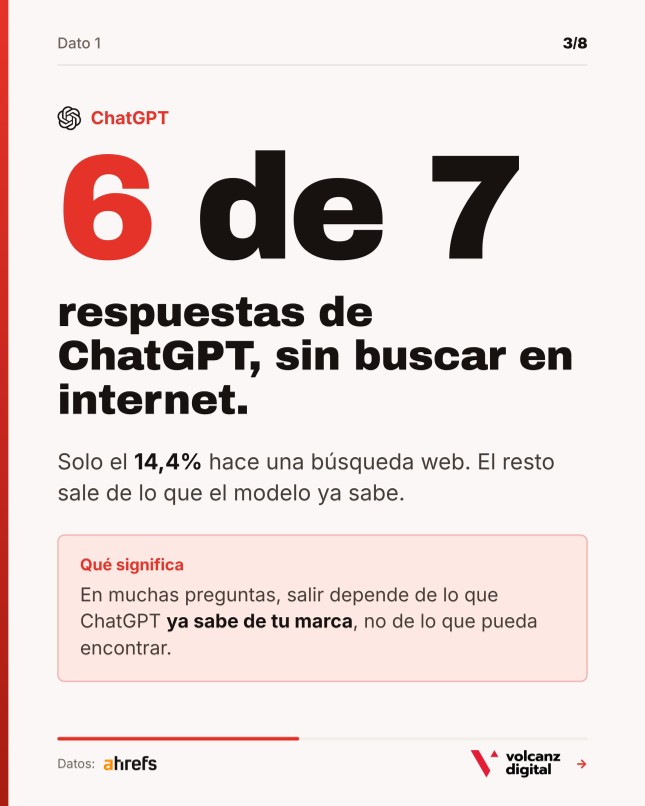
Poco. El 14,4% de las respuestas analizadas activó una búsqueda. Cuando lo hace, lanza de media 1,6 consultas, no diez ni veinte. Ahrefs lo lee como una decisión de costes: cada búsqueda le cuesta dinero a OpenAI, así que el modelo gratuito se la ahorra siempre que crea poder responder de memoria.
14,4 % de las respuestas de ChatGPT gratuito lanza una búsqueda web, con 1,6 consultas de media cuando lo hace. — Ahrefs, octubre de 2026
Esto tiene una consecuencia directa para cualquier marca. Si tu estrategia de visibilidad en IA se basa solo en "estar bien posicionado para que me encuentre cuando busque", estás apostando al 14% de los casos. El otro 86% se decide con lo que el modelo ya sabe de ti.
Ojo: ese 14,4% es de la versión gratuita y sin sesión. Los modelos de pago y los de razonamiento buscan más. Ahrefs lo reconoce en el propio estudio y Search Engine Journal cita otro análisis sobre 4.000 prompts vía API con GPT-5.6 Sol que da 7,6 búsquedas por prompt. No son comparables entre sí, pero sirven para no tomar el 14,4% como una ley universal.
¿Qué busca cuando sí busca?
Aquí está, para mí, lo más interesante del estudio. Cuando ChatGPT decide buscar, su comportamiento se parece cada vez más al de alguien que quiere ir a la fuente:
- El 6,8% de las búsquedas internas (1 de cada 15) usa el operador site:, es decir, busca dentro de un dominio concreto. Afecta a unos 116.000 dominios.
- Entre los 160 dominios más buscados con site:, el 75,9% son webs de marca. Los primeros de la lista: apple.com, ikea.com, nike.com, adidas.com y samsung.com. Los retailers (Walmart, Costco, Amazon) se llevan un 11,9%. Reddit y Facebook juntos, un 1,9%.
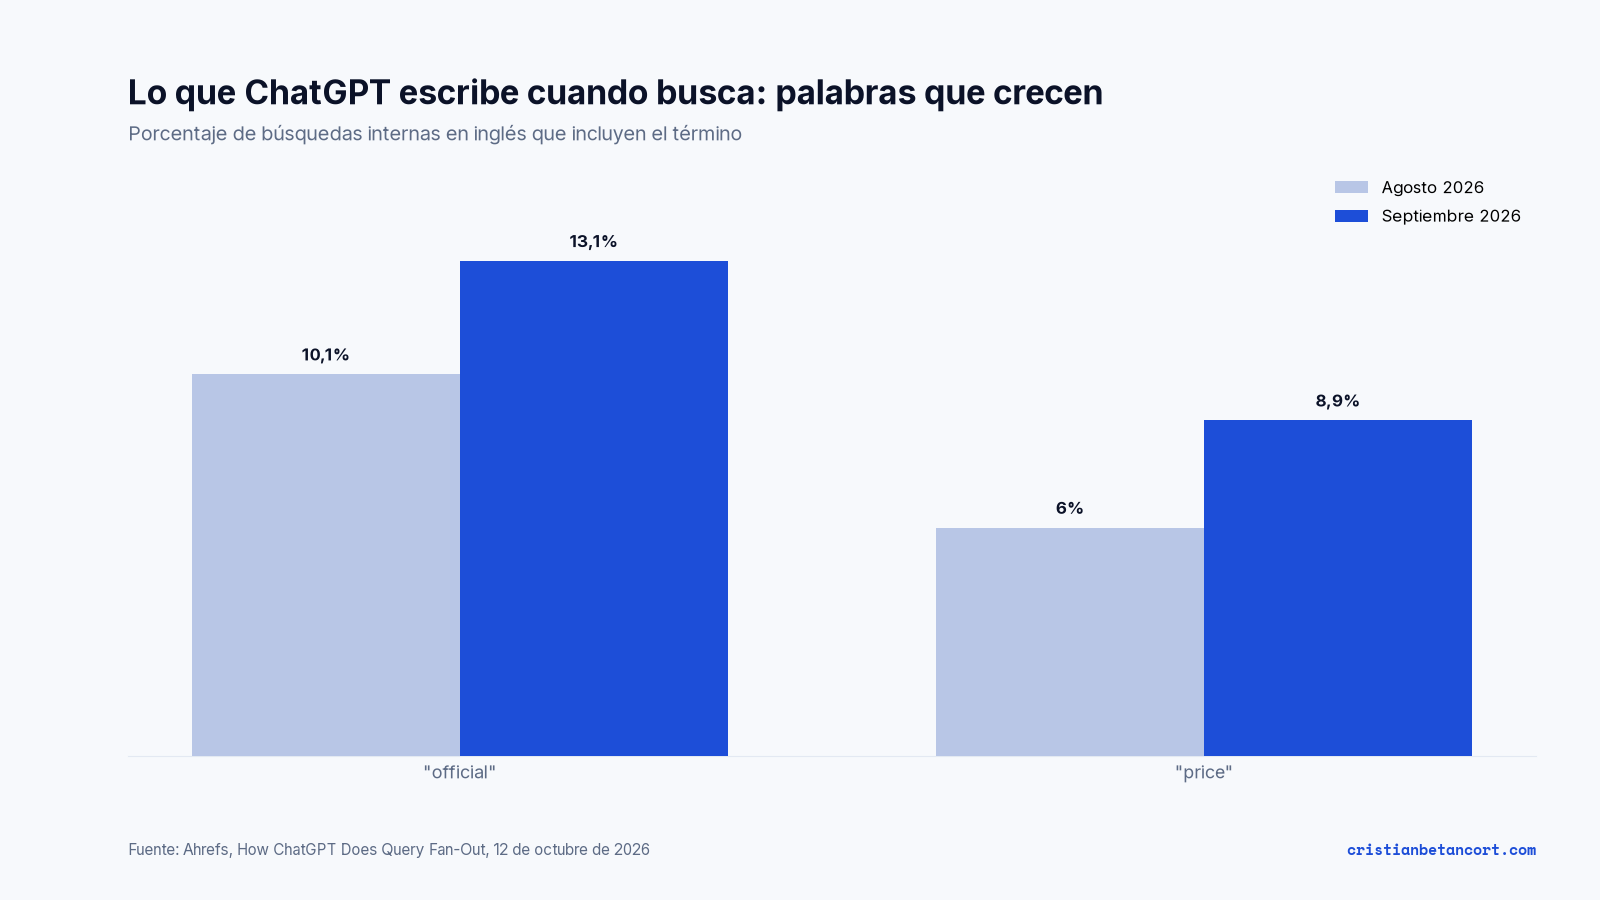
- La palabra "official" aparece en el 13,1% de las búsquedas en inglés de septiembre, frente al 10,1% de agosto.
- "Price" sube del 6,04% al 8,88%, "reviews" crece alrededor de un tercio y "specifications" entra entre los 50 términos más usados.
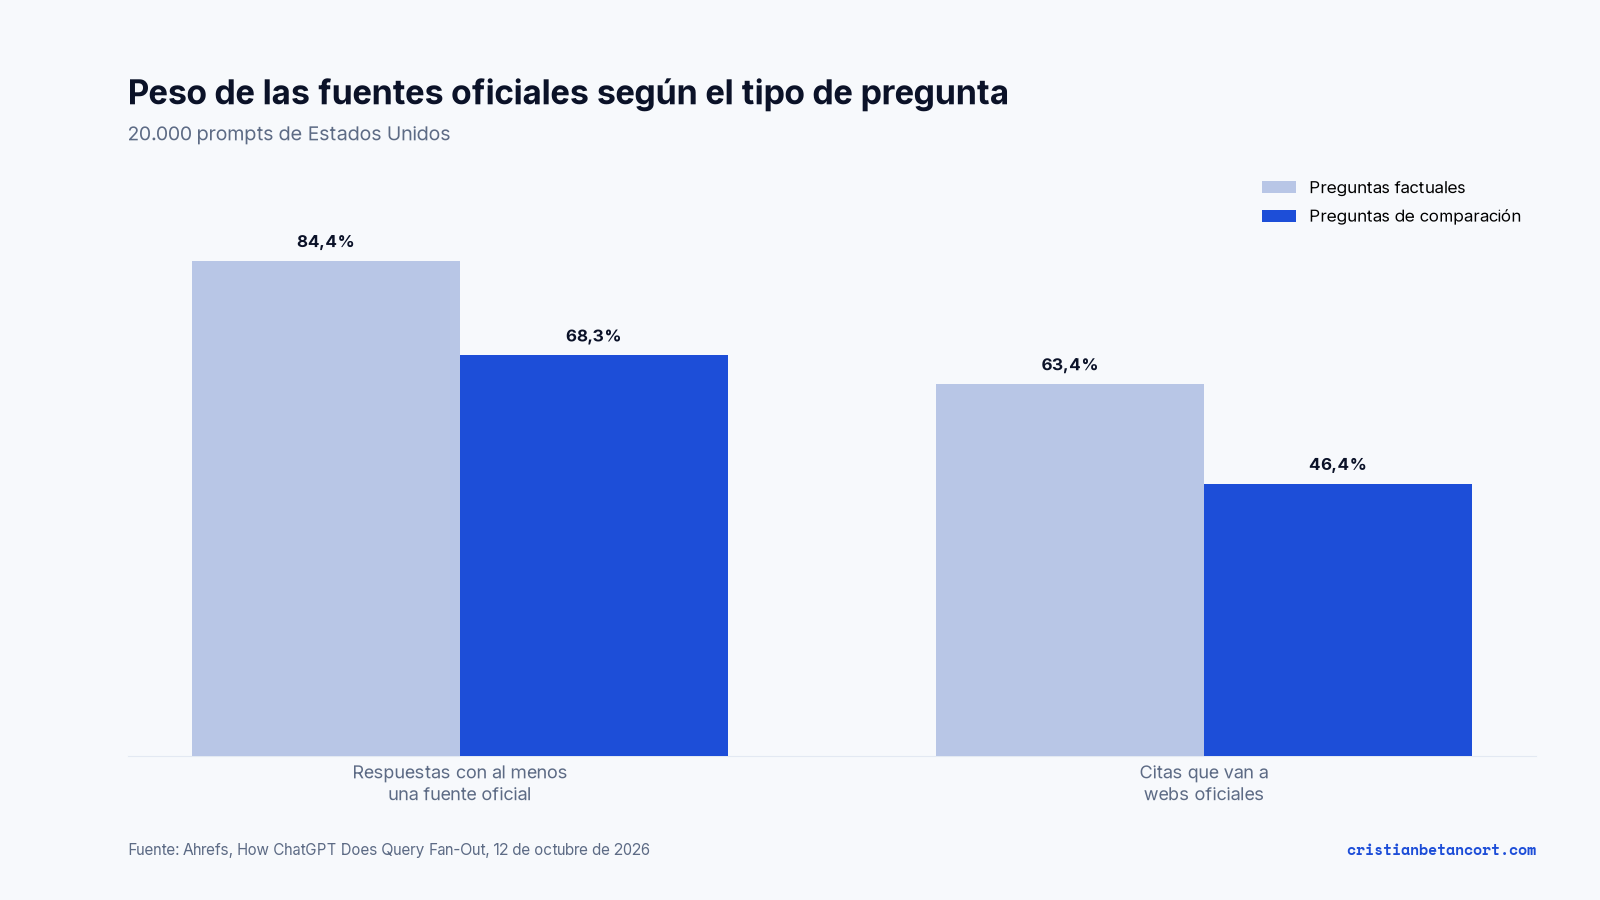
En 20.000 prompts de Estados Unidos, el 84,4% de las respuestas a preguntas factuales citaba al menos una fuente oficial, y el 63,4% de las citas iba a webs oficiales. En preguntas de comparación, los porcentajes bajan al 68,3% y 46,4%. Tiene sentido: para comparar necesitas a alguien que haya probado varias opciones, no solo al fabricante.
¿Quién gana y quién pierde citas en ChatGPT?
El dato de citas (recuerda: Estados Unidos, marzo a septiembre de 2026) muestra un movimiento muy claro. Lo resumo en una tabla:
| Dominio | Marzo 2026 | Septiembre 2026 | Tipo de fuente |
|---|---|---|---|
| 1 de cada 5 respuestas | 1 de cada 43 | Foro / opinión de usuarios | |
| Wikipedia | 1 de cada 7 | 1 de cada 35 | Enciclopedia |
| YouTube | 1 de cada 370 | 1 de cada 500 | Vídeo |
| PubMed | Puesto 64 | Puesto 4 | Investigación primaria |
| FDA | Fuera del top 200 | Puesto 8 | Regulador |
| WebMD | Puesto 18 | Puesto 79 | Divulgación que resume a otros |
| Britannica, Investopedia, New York Post | Dentro del top 200 | Fuera del top 200 | Enciclopedia / divulgación / prensa |
88 % menos de citas a Reddit y un 80 % menos a Wikipedia entre marzo y septiembre de 2026 en ChatGPT (EE. UU.). — Ahrefs, octubre de 2026
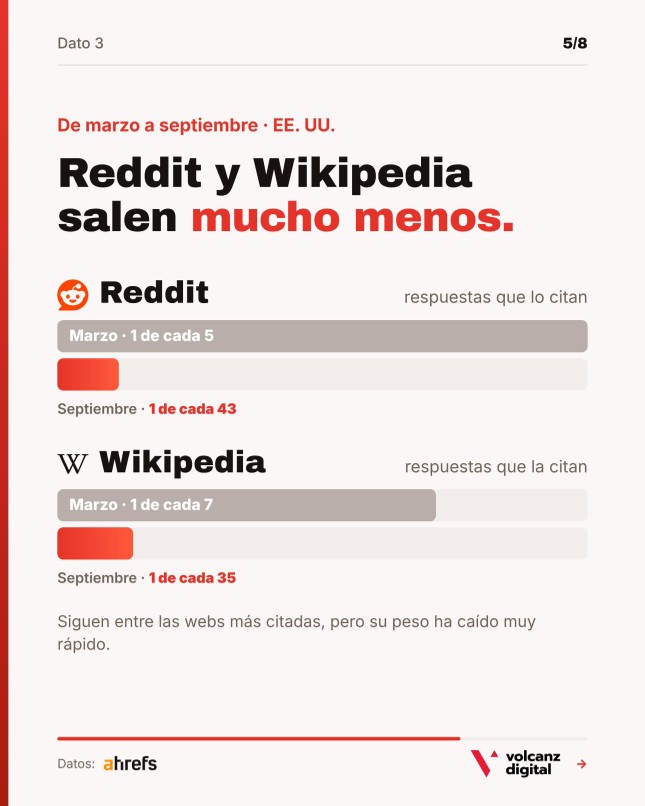
Los que suben son organismos de salud e investigación, reguladores, páginas de soporte de marcas y webs que prueban productos con sus propias manos (RTINGS, CarComplaints, RepairPal). Los que bajan son los que explican lo que otros publicaron antes: divulgación de salud y finanzas, enciclopedias y prensa generalista.
Ahrefs hizo una comprobación que me parece importante: cogió unos 25.000 prompts que estaban en el top 150.000 por volumen tanto en marzo como en septiembre y comprobó que todos los dominios del gráfico se movían en la misma dirección. Eso descarta, al menos en parte, que el cambio se deba a que la gente pregunta cosas distintas.
¿Por qué cae Reddit si tiene acuerdo con OpenAI?
Es la pregunta que se hace todo el mundo. Ahrefs cuenta 17 editores y plataformas con acuerdos de licencia con OpenAI. Reddit es el único de ellos que aparece entre los 150 dominios más buscados con site:, en el puesto 9. Y sin embargo sus citas se desploman.
La cuota de citas de los socios con licencia pasó del 7,5% en marzo al 15,8% en julio y volvió al 12,5% a finales de septiembre. Ahrefs plantea una posibilidad, no una conclusión: que el contenido licenciado ya esté disponible para el modelo sin necesidad de buscar, y por tanto no aparezca como cita. Lo apunto como lo que es, una hipótesis.
Ojo: lo de Reddit es una hipótesis de Ahrefs, no una conclusión. Que el contenido licenciado llegue al modelo sin pasar por la búsqueda explicaría la caída, pero nadie fuera de OpenAI lo puede confirmar.
Las dos formas de aparecer en ChatGPT
Si junto todo lo anterior, el estudio dibuja dos puertas de entrada y un pasillo que se está cerrando:
- Que te conozca tanto que no necesite buscarte. Es el 86% de las respuestas. Depende de la presencia de tu marca en los datos de entrenamiento, de las menciones consistentes en muchas fuentes y de que tu nombre esté asociado a una categoría clara.
- Ser la fuente original cuando sí busca. Es el 14%. Aquí mandan la web oficial, el dato primario, el precio real, la especificación, la prueba hecha con tus propias manos.
Lo que queda en medio, el contenido que solo resume lo que otro publicó antes, es lo que está perdiendo. Y no me parece casual. Google lleva tiempo en la misma dirección: en su guía de contenido útil, actualizada a principios de octubre de 2026, incluye la originalidad entre los cuatro atributos de calidad que evalúa, junto al esfuerzo, el talento y la precisión. Dos sistemas distintos, con incentivos distintos, pidiendo lo mismo: menos refrito y más fuente propia.
Un marco práctico: el test de la fuente propia
En Volcanz lo que vemos en proyectos es que casi nadie sabe decir, página por página, qué parte de su contenido es suyo de verdad. Propongo un ejercicio sencillo que puedes hacer con tu equipo en una tarde. Coge tus 30 o 50 URLs con más tráfico y clasifica cada una en uno de estos tres cajones:
| Cajón | Pregunta que lo define | Ejemplos | Qué hacer |
|---|---|---|---|
| A. Solo tú puedes publicarlo | ¿Esta información nace en tu organización? | Precios, fichas de producto, datos de clientes agregados, estudios propios, resultados de pruebas, políticas, documentación oficial | Protegerlo, estructurarlo, mantenerlo actualizado y en texto plano accesible |
| B. Tú lo has experimentado | ¿Has probado, medido o comparado algo con tus manos? | Reviews con metodología, comparativas con datos propios, casos documentados, análisis de datasets ajenos con criterio propio | Hacer visible la metodología y la autoría real |
| C. Cualquiera podría escribirlo | ¿Se podría redactar leyendo tres fuentes y sin salir de la oficina? | "Qué es X", "Guía completa de Y", resúmenes de noticias, definiciones | Fusionar, reconvertir en A o B, o asumir que no va a dar visibilidad en IA |
Después, tres preguntas:
- ¿Qué porcentaje de tu contenido está en el cajón C? Si pasa de la mitad, tienes un problema de estrategia, no de redacción.
- ¿Tu información del cajón A está donde ChatGPT la busca? El estudio dice que lanza site:tumarca.com buscando "official", "price", "specifications". Si eso vive en un PDF, detrás de un formulario o en una imagen, no existe.
- ¿Tu web oficial responde con claridad a "qué eres y qué haces"? Es lo que alimenta la puerta 1, la de la memoria del modelo. Las menciones consistentes en terceros ayudan, pero la fuente de la verdad tiene que ser la tuya.
Las cautelas que no hay que saltarse
Lo dije en LinkedIn y lo repito aquí con más detalle, porque un dato espectacular sin contexto es la forma más rápida de tomar malas decisiones:
- Es un solo modelo (GPT-5.6 Luna) en una ventana concreta (agosto y septiembre de 2026). OpenAI cambia la recuperación de información constantemente. Con la próxima actualización, los porcentajes pueden moverse.
- Es la versión gratuita y sin sesión. Busca menos que los modelos de pago y de razonamiento.
- Los prompts son amplios. Otros estudios usan prompts comerciales tipo "mejor X para Y", que disparan más búsquedas de marca.
- Las citas son solo de Estados Unidos y miden ranking de dominios, no tráfico. No tenemos un desglose para España ni para prompts en español.
- Ahrefs vende Brand Radar, la herramienta de la que salen los datos de citas. No invalida el estudio, pero conviene saberlo.
Aun así, la dirección es coherente con lo que hemos visto en los últimos meses y con lo que pide Google. Y en una situación de incertidumbre, apostar por ser la fuente original es la decisión que menos te puede salir mal, cambie lo que cambie el algoritmo.
Así que vuelvo a la pregunta con la que cerré el post: ¿cuánto de vuestro contenido podría publicarlo solo vuestra marca?
Preguntas frecuentes
¿ChatGPT busca en internet antes de responder?
Según el estudio de Ahrefs de octubre de 2026, solo en el 14,4% de las respuestas de la versión gratuita. El resto lo responde con lo que el modelo tiene aprendido. Los modelos de pago y de razonamiento buscan con más frecuencia.
¿Qué tipo de webs cita más ChatGPT?
Cada vez más, fuentes primarias: webs oficiales de marca, organismos públicos como PubMed o la FDA y sitios que prueban productos. Reddit, Wikipedia y los medios de divulgación que resumen a otros han perdido peso entre marzo y septiembre de 2026 en Estados Unidos.
¿Cómo consigo que ChatGPT cite mi web?
Hay dos vías. Que el modelo conozca tu marca lo suficiente como para no necesitar buscarla, y ser la fuente original (precio, ficha, dato, prueba) cuando sí busca. El contenido que solo resume lo que otros publicaron es el que menos probabilidades tiene.
¿Sirven estos datos para España?
Con cautela. Las búsquedas internas son de todos los países, pero las citas son solo de Estados Unidos y en inglés. La tendencia hacia la fuente oficial es razonable esperarla también en español, pero no hay datos que lo confirmen todavía.
Fuentes
- Ahrefs: ChatGPT query fan-out study (Louise Linehan, 12 de octubre de 2026)
- Relevant Audience: ChatGPT answers 6 in 7 prompts without searching
- Google Search Central: Creating helpful, reliable, people-first content
- Google Search Central: Using generative AI content
COO & Head of Digital (AI) en Volcanz Digital y director del Máster, cursos y talleres de IA aplicada al Marketing Digital en DKS. Escribo cada semana sobre IA, búsqueda y operaciones. Sígueme en LinkedIn.